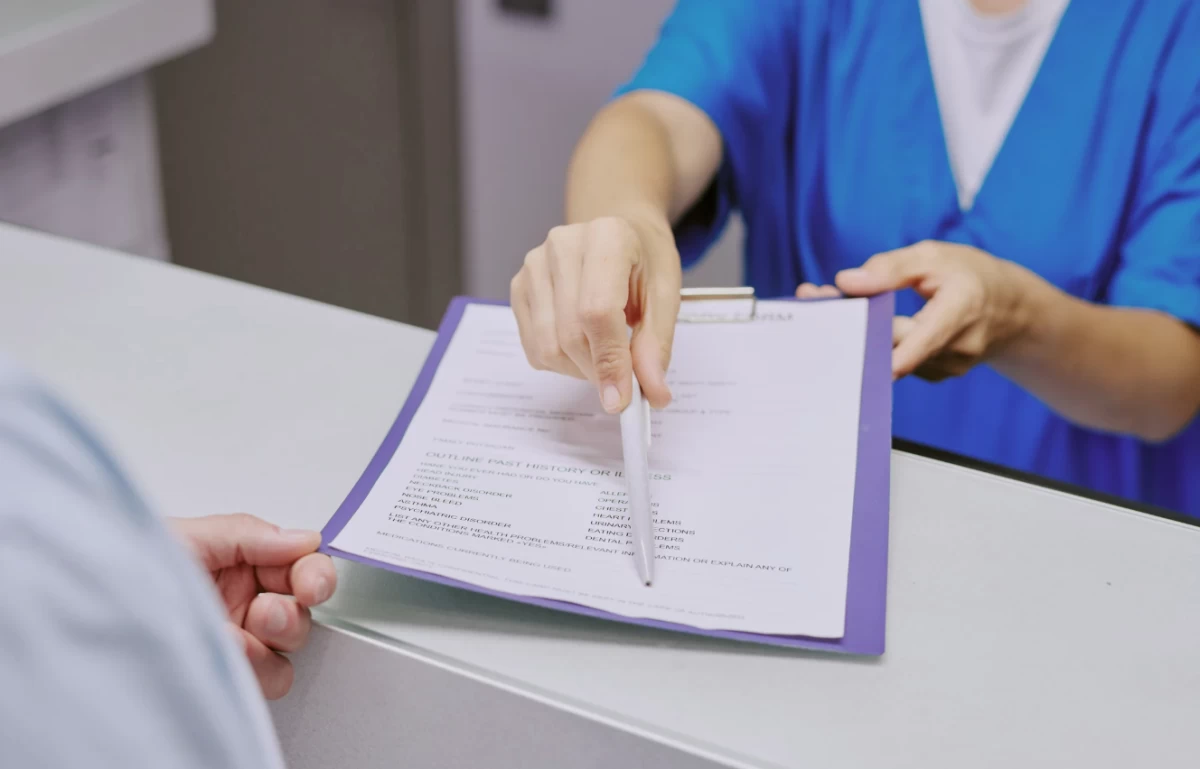


وقارن الباحثون بين ملخصات أعدها نموذج لغوي كبير وأخرى صاغها أطباء، بالاعتماد على السجلات الطبية لـ60 حالة دخول إلى مستشفى ستوني بروك الجامعي، تراوحت فترات إقامة أصحابها بين 7 و21 يوما. وشملت الدراسة تقييما أجراه أطباء متخصصون في الطب الباطني والرعاية الأولية، ركز على الجودة العامة للملخصات وسهولة قراءتها ودقتها ومدى اكتمال المعلومات الواردة فيها. وأظهرت النتائج أن الملخصات المنتجة بالذكاء الاصطناعي كانت أكثر وضوحا وأسهل قراءة، كما احتوت على عدد أقل من التفاصيل السريرية الناقصة مقارنة بالملخصات التي أعدها الأطباء، فضلا عن كونها أكثر ملاءمة لشرح الحالة الصحية للمرضى ومقدمي الرعاية ومتابعة العلاج بعد الخروج من المستشفى. ويرى الباحثون أن هذه النتائج تبرز إمكانات النماذج اللغوية الكبيرة في تطوير آليات التوثيق الطبي وتحسين جودة المعلومات المقدمة عند انتقال المرضى من المستشفى إلى الرعاية الصحية اللاحقة. لكن الدراسة لم تعتبر الذكاء الاصطناعي بديلا عن الأطباء، إذ أكدت أن كلا النوعين من الملخصات قد يتضمن أخطاء، مشددة على أهمية المراجعة الطبية والتحقق من دقة المعلومات قبل إدراج أي محتوى ينتجه الذكاء الاصطناعي في السجل الطبي للمريض.